
不是喊口号,是真动手了。腾讯云最近在世界人工智能大会上甩出一句硬话:‘要把推理成本压到极致’——紧接着就宣布大规模上马国产芯片,2026年Q4直接干出NPO超级节点。这不是小打小闹的试点,而是从服务器架构、光互连方案到软件栈全链条的国产化切换。业内测算,单靠NPO方案就能省掉光模块里最贵的DSP芯片,功耗降15%-20%网上配资炒股公司,带宽密度翻倍;再加上国产AI芯片规模化采购带来的议价权,整体推理成本下降30%并非空谈。
三大实锤技术突破撑起了这次切换:第一是NPO(近封装光学)落地节奏比预想快——它不追求一步到位的CPO那种‘芯片级融合’,而是把光电转换芯片和GPU放在同一块板卡上,距离缩到毫米级,既绕开了现有产线大改造的麻烦,又实打实砍掉了DSP成本;第二是国产算力软硬协同开始跑通,比如智谱收购中科加禾,就是补上编译优化这一环,让国产芯片‘跑得动大模型’;第三是真实业务场景验证完成,腾讯云已在多个内部AI服务中完成国产芯片适配,不再是实验室参数,而是能扛住微信搜索、广告推荐、视频生成等高并发推理负载。
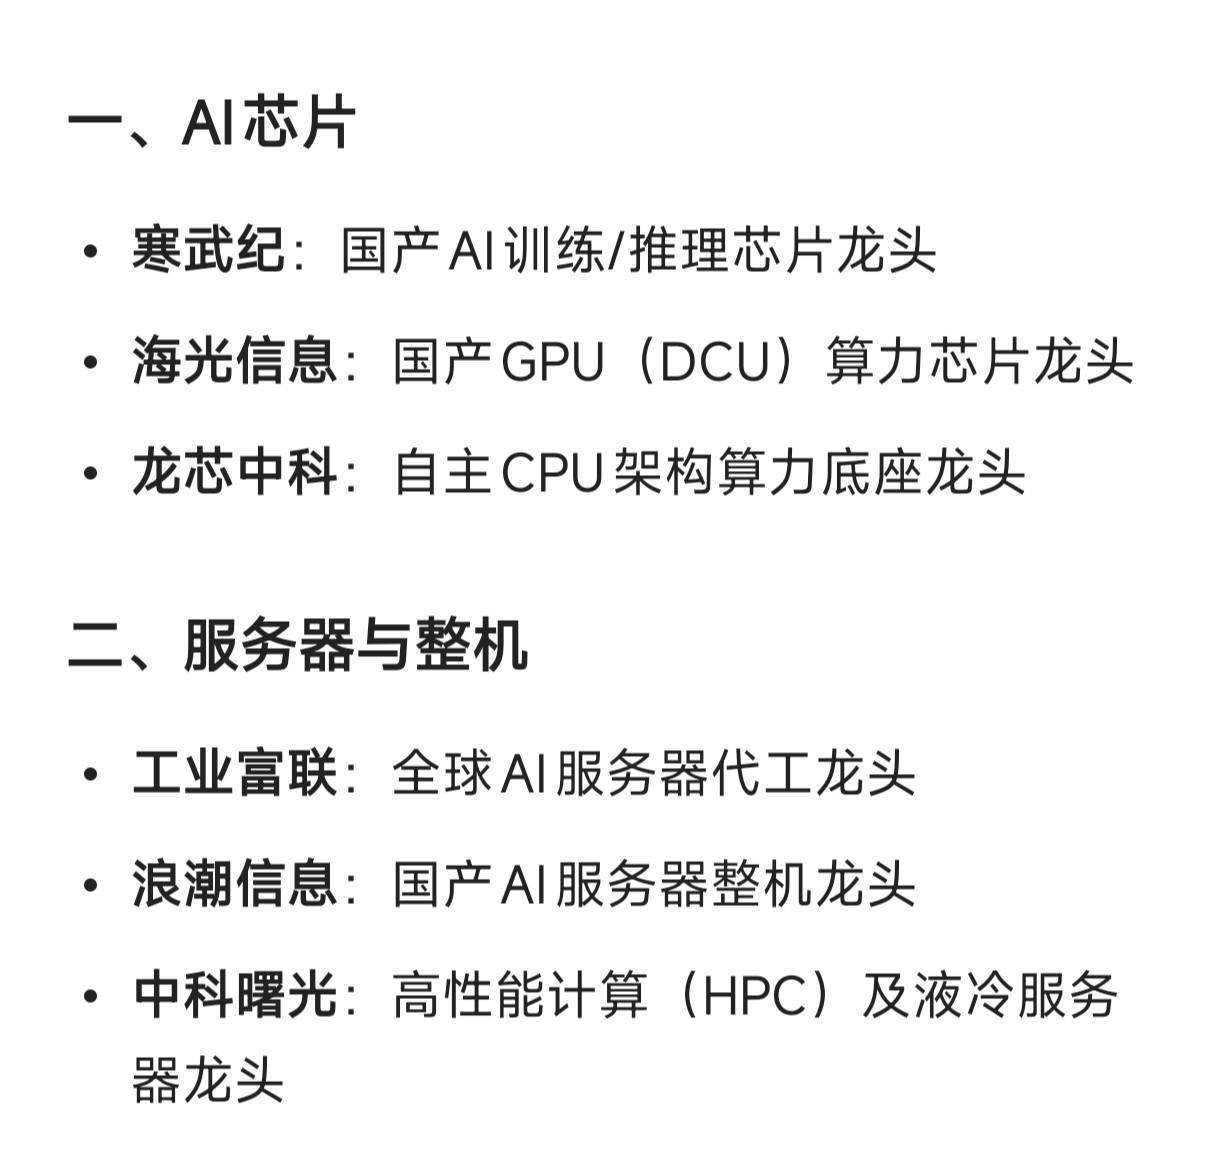
别小看这波动作。它背后是整个AI基建逻辑的转向:过去拼谁家GPU多,现在拼谁能把算力‘用得更省、更稳、更贴业务’。国资委推‘AI+’专项行动,央企带头开放场景;腾讯云押注NPO标准,其实是抢下一代光互连的话语权;连带着,像曦智科技、寒武纪、壁仞这些上下游厂商,也不再单打独斗,而是在统一架构下分工协作。国产算力,正从‘能用’迈向‘好用’,再奔着‘必选’去。
这事儿真不是画饼。去年底腾讯云在内部测试时,就把微信视频号的AI审核模型切到了国产芯片集群上。高峰时段每秒处理20万条短视频,延迟压到80毫秒以内——比原来用A100的方案还稳了5%。一线工程师私下聊起来都说:“以前调参得围着英伟达驱动打转,现在用国产工具链,改个算子编译一次只要3分钟,迭代速度翻了一倍。”
更实在的是钱袋子的变化。某头部电商客户今年把实时推荐系统迁到腾讯云国产算力平台后,单日推理费用从12万元降到不到8万元,省下的钱直接投进了新模型训练。这不是个别案例,据信通院《2024人工智能基础设施发展白皮书》披露,采用国产化推理方案的企业,平均TCO(总拥有成本)下降27.3%,其中超六成来自电力与散热成本压缩。
有人担心“换芯”会不会影响体验?数据说话:腾讯云公开的实测报告显示,Qwen2-72B大模型在寒武纪MLU370上跑推理,吞吐量达到每秒112 tokens,误差率与同规格A100相差不到0.8%;而用壁仞BR100跑Stable Diffusion v2.1,出图质量PSNR值92.6,跟H100基本持平。这些数字背后,是过去三年国内厂商累计提交的AI编译器专利超1800件,光是算子融合优化这一项,就让主流模型在国产芯片上的利用率从不足60%提到了89%。
当然,路还没走完。NPO光互连的良率还在爬坡,部分高带宽场景仍需进口激光器;国产AI芯片的FP8精度支持刚起步,大模型训练环节仍有依赖。但方向已经很清晰:不靠堆卡,靠精算;不拼参数,拼落地。当一个视频生成任务能在国产平台上用1/3电费跑完,当广告点击率预测模型在国产芯片上多迭代两轮、CTR提升0.3个百分点——这些才是企业真正愿意掏钱的理由。
说白了,国产算力不再需要解释自己“为什么行”,而是用每天省下的电费单、快出来的结果、稳住的业务峰值,默默改写行业规则。这波切换,不是替代,是升级;不是对抗网上配资炒股公司,是进化。
文章为作者独立观点,不代表配资行业查询_配资查询114_股票配资114观点